日常高频使用 Codex、Claude Code 等多个 AI 编程工具时,很快会遇到两个痛点:上下文被锁死在各自工具的私有格式里,以及跨会话、跨时间维度的代码与决策记忆极易丢失或检索失真。
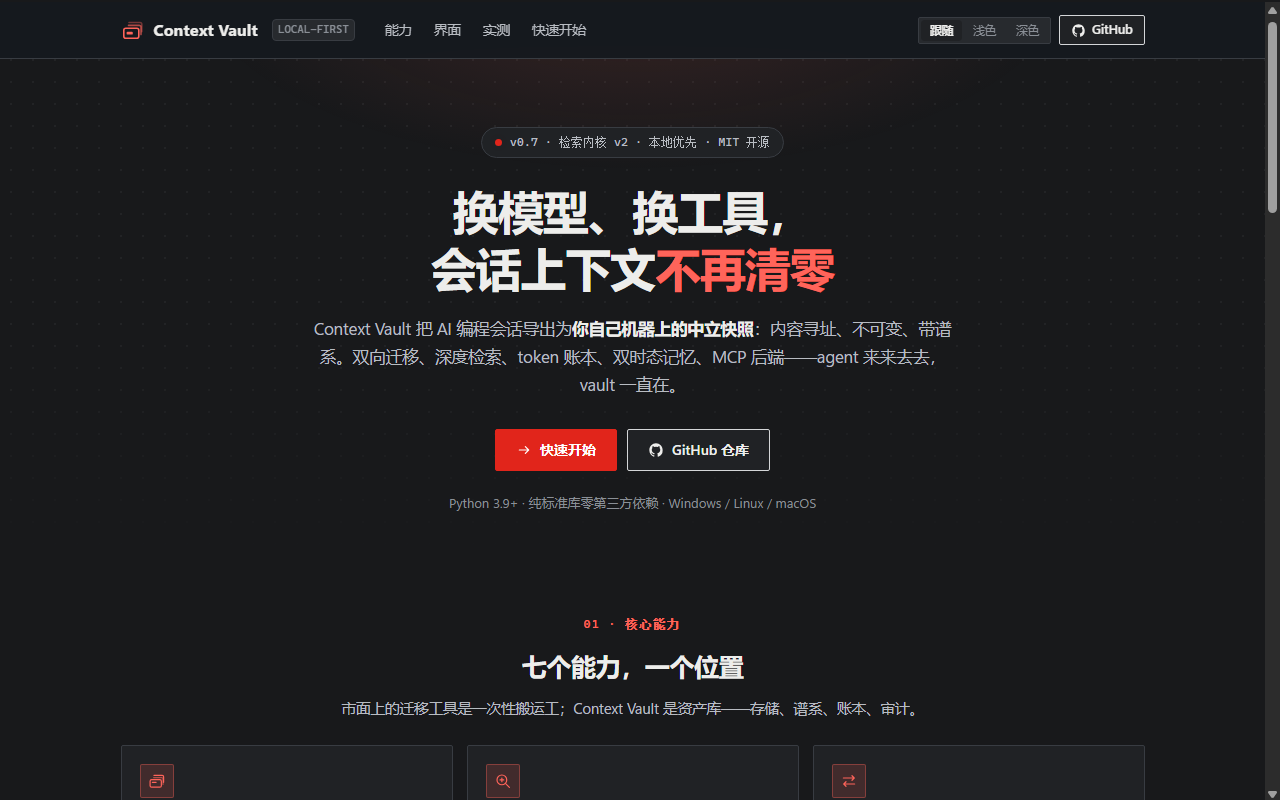
Context Vault(官网:vault.nghqqa.cn)是我为解决这一问题打造的本地优先跨 AI 编程工具上下文资产库与记忆服务。到 v0.7.0 版本为止,它坚持 Python 纯标准库 + SQLite 零依赖路线,提供 6 工具 MCP 服务,并配套构建了 162 题零泄漏评测基准 CodingVault-Bench 与 162 项测试 + 双平台 CI。
一、零依赖本地存储:不可变内容寻址快照与索引瘦身
选择 Python 纯标准库 + SQLite 的原因很直接:开发者工具必须开箱即用、零环境摩擦、数据完全留在本地。
- 不可变内容寻址快照:会话历史、文件片段与工作区状态按内容哈希寻址存储,天然去重且不可篡改,支持随时精确回溯与恢复。在真机实测中,195MB 会话可在 1.5s 内完成导出,并恢复 37.3 万 token。
- Codex / Claude Code 双向迁移:在统一内部模型之上实现双向适配器,让不同 Coding Agent 沉淀下来的会话资产可以无损流转,不再被单一工具绑定。
- 索引存储压缩:随着历史快照累积,索引体积很容易膨胀。我们在
v0.7.0中对存储与索引结构做了深度收敛,将 2,000+ 快照的索引体积由 778.5 MiB 压缩至 100.9 MiB(下降 87%),同时将检索 P95 延迟控制在 39.0ms。
二、代码感知检索、双时态记忆与 4K 预算简报
传统面向自然语言的向量检索,在编程场景下常常“水土不服”——例如用户搜 camelCase 标识符,历史记录里却是 snake_case 或带模块前缀的写法;或者昨天刚推翻的架构方案,今天依然因为语义相似度高而被召回。
Context Vault 在检索与记忆层重点解决了三件事:
- 代码感知检索:针对代码标识符分词、路径与符号特征优化匹配策略,提升跨命名风格与跨写法的命中率。
- 双时态记忆(Bi-temporal Memory):区分事实的“业务有效时间”与“系统记录时间”,避免过时结论污染当前决策。
- 6 工具 MCP 服务与 4K 预算简报:通过标准化的 6 个 MCP 工具向外部 Agent 暴露检索、快照、迁移与记忆能力;在恢复现场时,系统可在 100ms 内生成 4K token 预算的上下文简报,且关键文件召回 ≥95%。
三、CodingVault-Bench:162 题零泄漏评测基准
没有量化评测的检索优化很容易变成“自我感觉良好”。为了严格检验检索质量与防污染能力,我们构建了 162 题零泄漏评测基准 CodingVault-Bench(严格隔离训练/调优语料与评测集,确保零泄漏)。
在 CodingVault-Bench 上的核心实测结果如下:
| 评测维度 | 优化前 / 基线 | Context Vault v0.7.0 |
|---|---|---|
| 跨写法召回 | 0.69 | 0.89 |
| 无关记忆入侵率 | 0.98 | 0 |
| 时序召回 | — | 0.88 |
其中最关键的变化是入侵率从 0.98 降至 0——在编码场景下,召回一条已经失效或属于错误时间线的历史决策,往往比“没召回”更具破坏性。
四、工程质量保障
作为一个每天自用、也面向个人开发者开源的本地基础设施,Context Vault 在 v0.7.0 建立了完整的回归防线:
- 162 项自动化测试:覆盖快照导入导出、跨 Agent 迁移、索引压缩、双时态检索与 MCP 协议边界。
- 双平台 CI:在 Windows 与 Linux 环境下持续验证路径处理、SQLite 锁行为与 CLI 兼容性。
小结
Context Vault 的实践让我深刻体会到:AI 编程工具的下一阶段竞争,不只是模型本身,更是本地上下文资产的沉淀、跨工具迁移与低延迟精准召回。用零依赖的 SQLite 把数据主权交还给开发者,再用零泄漏基准守住检索质量下限,是这条路线能长期演进的基础。