第一章 绪论
-
智能是( )和( )的总和?
智力
知识
-
( )是一切智能行为的基础?
知识
-
( )是获取知识并应用知识求解问题的能力?
智力
-
智能的特征有( )、( )、( )、( )?
具有感知能力
具有学习能力
具有记忆与思维能力
具有行为能力
-
人工智能的长期目标是?
长期目标是制造智能机器
(短期目标实现机器智能)
-
人工智能的主要研究内容有( )、( )、( )、( )、( )
知识表示
机器感知
机器学习
机器行为
机器思维
-
人工智能的定义是什么?
人工智能的定义是用人工的方法在机器上实现的智能
-
简述“图灵测试”?
图灵测试是让人和机器在两个房间内,二者相互通话,但是彼此不见面,如果通过对话,人类一方无法分辨对方是人或者机器人,那么可以认为对面机器达到了人类智能水平
-
人工智能是一门( )学科
综合性交叉
-
人工智能这个名词出现于( )
1956年达特茅斯学院,由麦卡锡发起的学术研讨会上
-
人工智能有三大学派( ),( ),( )
连接主义学派
行为主义学派
符号主义学派
-
人工智能的研究领域和应用领域
研究领域:机器视觉(CV),自然语言理解(NLP),机器人技术,数据挖掘和知识发现(DM,KDD),机器学习(ML),知识表示等
应用领域:自动驾驶,智慧城市,智慧医疗,金融服务,智能家居等
第二章 知识表示与知识图谱
-
知识的特性有( )、( )、( )
相对正确性,不确定性,可利用性和可表示性
-
造成知识具有不确定性的原因主要有( )、( )、( )、( )
随机性,模糊性,经验(不一致性),不完全性
-
知识表示是( )
将人类知识形式化或模式化。
-
人工智能中逻辑分成哪两类?
- 经典逻辑和一阶谓词逻辑:真值为真或者假,又称为二值逻辑
- 非经典逻辑:包括三值逻辑,多值逻辑,模糊逻辑等
-
命题是可以判断真假的( )
陈述句
-
仅个体变元被量化的谓词称为( )
一阶谓词
-
在人工智能领域内显式的知识表示方法主要有( )、( )、( )、( )
一阶谓词逻辑表示法,产生式表示法,框架表示法,语义网络表示法
-
谓词的一般形式是( )
-
一阶谓词逻辑表示法的优缺点是?
优点:自然性,精确性,严密性,容易实现
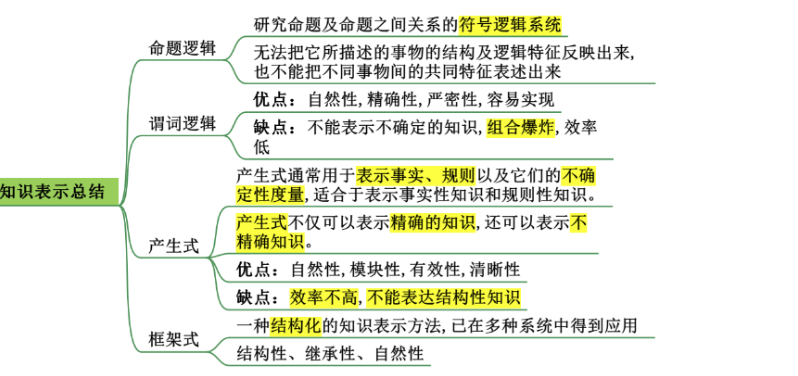
缺点:不能表示不确定的知识,组合爆炸,效率低
-
一个产生式系统由( )、( )和( )三部分组成
控制系统(推理机)
规则库
综合数据库
-
在产生式系统中,推理机的工作是( )、( )、( )、( )
-
推理
-
冲突消解
-
执行规则
-
检查推理终止条件
-
产生式表示法的优缺点
优点:自然性,模块性,有效性,清晰性
缺点:效率不高,不能表示具有结构性的知识
-
位于量词后面的单个谓词或者用括弧括起来的谓词公式称为量词的( ),域内与量词中同名的变元称为( ),不受约束的变元称为( )
辖域
约束变元
自由变元
-
框架表示法的优点
优点:结构性,继承性,自然性
-
在谓词公式中,连接词的优先级别从高到低排列是( ),( ),( ),( ).( )
-
对于谓词公式P,如果至少存在一个解释使得P在此解释下的真值为T,则称P是( )
可满足的
-
当谓词公式G是(), 当且仅当对所有的解释G都为假
不可满足的
-
用谓词公式表示知识的一般步骤?
1.定义谓词
2.变元赋值
3.使用连接词连接谓词,形成谓词公式
-
知识图谱三元组的基本形式主要分为两种形式:( )、( )
(实体1—–关系——–实体2)
(实体—–属性——–属性值)
-
知识图谱中的圆形节点表示( ),连接线(链)表示( )
圆形:实体/概念
链:关系/属性
-
知识图谱在逻辑上分为( )和( )
模式层与数据层
其中模式层在数据层之上,是知识图谱的核心
-
对于事实性知识,由( )和( )连接形成的谓词公式表示。
(合取)和 (析取)
-
产生式系统的推理中,一般需要考虑( )
冲突消解策略
-
利用哪些规则可以得到谓词公式?
- 单个谓词是谓词公式,也称为原子谓词公式
- 当是谓词公式,则也是谓词公式
- 当和都是谓词公式时,则也是谓词公式
- 当是谓词公式,则也是谓词公式
- 有限步应用上述1-4步生成的公式也是谓词公式
-
三种表示法表示知识的不同
谓词表示法:表示准确的知识(精确性)
产生式表示法:表示因果性知识(有效性 )
框架表示法:可以表示因果性知识和更复杂的知识(结构性+继承性)
知识表示总结:
第三章 确定性推理方法
- 推理的定义?
推理是从某种初始证据出发,按某种策略不断运用知识库中的已知知识逐步推出结论的过程
-
构成推理的两个基本要素是( )和( )。
知识与已知事实(证据)
-
若从推出结论的途径来划分,推理可分为( )、( )和( )。
演绎推理,归纳推理,默认推理
-
若从推理使用的知识的确定性来划分,推理可分为( )、( )。
确定性推理和不确定性推理
-
若从推出的结论是否越来越接近最终目标来划分,推理可分为( )、( )。
单调推理和非单调推理
-
若按推理中是否运用与推理有关的启发性知识来划分,推理可分为( )和( )。
启发式推理和非启发式推理
-
推理的方向分为( ),( ),( )和( )。
正向推理
逆向推理
混合推理
双向推理
-
正向推理是以( )作为出发点的一种推理。
已知事实
-
逆向推理是以( )作为出发点的一种推理。
某个假设目标
-
混合推理可用于( )、( )和( )三种情况
已知事实不充分
正向推理推出的结论可信度不高
希望得到更多结论
-
双向推理的基本思想?
一方面根据已知事实进行正向推理,但不推导至最终目标,另一方面从某种假设目标进行逆向推理,但不推理到原始事实,而是让它们中途相遇,当正向推理所得到的中间结论恰好是逆向推理此时所要求的证据,这时推理可结束,逆向推理所做的假设就是推理的最终结论。
-
归结原理中的缩写词MGU是指( )
最一般合一(用常量替换变量 写法为{a/x} 用a换x)
-
冲突消解策略的基本思想是( )
对于知识进行排序
-
常用的冲突消解策略有( )、( )、( )和( )。
-
按规则的针对性排序
-
按已知事实的新鲜性排序
-
按匹配度排序
-
按条件个数排序
-
自然演绎推理的概念?
从一组已知为真的事实出发,直接运用经典逻辑的推理规则推出结论的过程称为自然演绎推理。
-
基本的自然演绎推理是( )、( )、( )和( )等。
规则(前提引入)
规则(结论引入)
假言推理:
表示:由及为真,可推出为真。
拒取式推理:
表示:由为真及为假,可推出为假
-
P规则、T规则、CP规则的概念?
规则允许我们在推理过程中直接使用前提
规则允许我们根据已有的命题公式推导出新的命题公式
规则允许我们在推理过程中引入附加前提
-
任何文字的( )称为子句。
析取()
-
原子谓词是( )
一个不能再分解的命题。
-
原子谓词公式及其否定称为( )
文字
-
谓词公式不可满足的充要条件是( )
其子句集不可满足
-
谓词公式化为子句集的步骤是什么?
步骤:
-
消去谓词公式中得与符号
,
-
把否定符号移到紧靠谓词的位置上,一般利用谓词公式的等价关系
双重否定律:
德摩根律:
量词转化率:
-
变量标准化:重新命名变元,使每个量词采用不同的变元,从而使不同量词的约束变元有不同的名字
-
消去存在量词
存在量词不出现在全称量词辖域内直接常量替换
存在量词出现在全称量词辖域内使用skolem函数替换
-
把全称量词全部移到公式最前面,化为前束型,并使每个量词得辖域包括这个量词后面公式得整个部分。前束型=(前缀){母式}
-
化为skolem标准型,一般利用分配律
-
略去全称量词
-
消去合取词
-
子句变量标准化(换元)
-
-
鲁滨逊归结原理(消解原理)的基本方法是什么?
基本方法是:检查子句集是否包含空字句,若包含,则不满足;
若不包含,就在子句集中选择合适的字句进行归结,一旦通过归结得到空字句,就说明子句集是不可满足的。
-
归结反演的定义是什么?其一般步骤是什么?
归结反演定义为:应用归结原理进行定理的自动证明
一般步骤是:
-
将已知前提表示为谓词公式
-
将待证明的结论表示为谓词公式,并否定得到
-
将谓词公式集{,}化为子句集
-
应用归结原理对子句集S中的字句进行归结,并把每次归结到的归结式都并入中。反复进行。若出现空字句,则停止归结,此时就证明了为真。
-
-
应用归结原理求解问题的步骤是什么?
- 把已知前提条件用谓词公式表示出来,并化成相应得子句集,设该子句集得名字为
- 把待求解得问题也用谓词公式表示出来,然后将其否定,并与一谓词 构成析取式。谓词就是一个为了求解问题专设的谓词,其变量必须与问题公式得变量完全一致。
- 把问题公式与谓词构成得析取式化为子句集,并把该子句集与 合并构成句集 。
- 对子句集 应用谓词归结原理进行归结,在归结得过程中,通过合一置换,改变 中的变元。
- 如果得到归结式, 则答案即在谓词中。
第四章 不确定性推理方法
-
在不确定推理中,“不确定性”一般分为:( )和( )。
知识的不确定性
证据的不确定性
-
不确定推理需要解决的重要问题是( )、( )、( )、( )、和( )。
不确定的表示和度量
不确定性的匹配算法及阀值
组合证据不确定性的算法
不确定性的传递算法
结论不确定性的合成
-
表示在规则 中,证据 为真的作用下结论为真的( )。
概率
-
表示在规则中,证据为真的作用下结论为真的( )。
信度
-
可信度的定义?
根据经验对于一个事物或者现象为真的相信程度称为可信度
-
在模型中,知识是用产生式规则表示的,其一般形式为( )
是该条知识的可信度,称为可信度因子
(它指出前提条件对应的证据为真时,它对结论为真的支持程度)
-
在[-1,1]上取值,>0表示( );<0表示( );=0表示( );=-1表示( );=1表示()
>0表示该条知识某种程度上为真
<0表示该条知识某种程度上为假
= 0表示该条证据的出现与结论无关
= -1表示该条知识为假
= 1表示该条知识为真
-
CF(E)在[-1,1]上取值,CF(E)>0表示( );CF(E)<0表示( );CF(E)=0表示( );CF(E)=-1表示( );CF(E)=1表示( )
> 0表示该条证据某种程度上为真
< 0表示该条证据某种程度上为假
= 0表示该条证据未获得任何观察
= -1表示该条证据为假
= 1表示该条证据为真
-
在模型中,结论H的可信度的计算公式是( )。
-
两条知识推出相同的结论,但可信度不同,求出该结论的步骤是什么?
-
分别对于每一条知识求出
-
在求出和对H的综合影响所形成的可信度
h(n) \leqslant h^{*}(n) ,对于所有节点n
时,被称为$A^{*}$算法 - $A^{*}$搜索算法的特性 1. 可采纳性:搜索算法可在最短路径存在时在有限步内找到它,宽度优先搜索是$A^{*}$的一种特例 2. 单调性:总是从祖先状态沿着最佳路径到达任一状态 3. 信息性:信息性更强,启发知识更多 # 第六章 智能计算及其应用 - 基本遗传算法(SGA)的遗传操作包括( )、( )、( ) 选择算子,交叉算子,变异算子 - 遗传算法中所用的函数是( ) 适应度函数 - 选择个体的方法( ),( ),( ) 1. 轮盘赌选择方法:按个体选择概率生成一个轮盘,轮盘每个区域的角度与个体的选择概率成正比,然后产生一个随机数,落入那个区域就选择相应个体 2. 锦标赛选择方法:随机选择k个个体,将其中适应度最高的个体保存到下一代 3. 最佳个体保存法:把群体中最高适应度的一个或者多个保存到下一代 - PSO是什么? PSO是粒子群优化算法 - 粒子群中算法中公式的解释 $v_{j}^{i}(k+1)=\omega(k) v_{j}^{i}(k)+\varphi_{1} \operatorname{rand}\left(0, a_{1}\right)\left(p_{j}^{i}(k)-x_{j}^{i}(k)\right)+\varphi_{2} \operatorname{rand}\left(0, a_{2}\right)\left(p_{j}^{g}(k)-x_{j}^{i}(k)\right)$ $\omega $是惯性权重因子。$\varphi_{1}$、$\varphi_{2}$ 是加速度常数 第二部分为认知分量$\varphi_{1}$,第三部分为社会分量$\varphi_{2}$ 当$\varphi_{1}>0 ,\varphi_{2}>0$时,称这个算法为PSO全模型(全考虑) 当$\varphi_{1}>0 ,\varphi_{2}=0$时,称这个算法为PSO认知模型(仅自我认识) 当$\varphi_{1}=0 ,\varphi_{2}>0$时,称这个算法为PSO社会模型(社会认识) 当$\varphi_{1}=0 ,\varphi_{2}>0,且g \neq i$时,称这个算法为PSO无私模型 如果只有第一部分,即$\varphi_{1}=\varphi_{2}=0$,则粒子群将一直以当前速度飞行,直到达到边界,由于它只能搜索有限部分,很难找到最优解 如果没有第一部分$\omega=0$,此时粒子群将收敛到当前的全局最优位置,更像是一个局部算法 如果没有第二部分,即$\varphi_{1}=0$此刻粒子群没有认知能力,它的收敛速度比标准模型更快,但是更加容易陷入局部最优解 如果没有第三部分,即$\varphi_{2}=0$此刻粒子群没有社会共享信息,它得到最优解的概率非常小 - 蚁群算法中挥发度有哪三种不同模型 全局更新:蚂蚁圈系统 局部更新:蚂蚁数量系统和蚂蚁密度系统 - 蚁群算法的参数 信息素启发因子$\alpha$:反应了蚁群在路径搜索中随机性因素作用的强度,$\alpha$值越大,蚂蚁选择以前走过路径的可能性越大,搜索的随机性减弱,当$\alpha$过大时会使蚁群算法的搜索过早陷入局部最优。 期望值启发式因子$\beta$:反映了蚁群在路径搜索的先验性,$\beta$值越大,蚂蚁在某个局部点上选择局部最短路径的可能性越大,收敛性加快,但是随机性减弱,容易陷入局部最优。 信息素挥发度$1-\rho$:关系到蚁群的全局搜索能力和收敛速度。当$1-\rho$过大时,将会影响算法的随机性能和全局搜索能力,当$1-\rho$过小时,能提高算法的随机性能和全局搜索能力,但会影响算法的收敛速度。 # 第七章 专家系统 - 专家系统是什么? 专家系统是一种智能的计算机程序,它运用知识和推理来解决只有专家才能解决的复杂问题,一类包含知识和推理的智能计算机程序 - 专家系统的特点有哪些? 专家系统的特点: 1. 具有专家水平的专业知识 2. 能进行有效的推理 3. 具有启发性 4. 具有灵活性 5. 具有透明性 6. 具有交互性 - 专家系统的编程思想 **专家系统=知识+推理** 而 **传统程序=数据结构+算法** - 专家系统一般由( )、( )、( )、( )、( )和( )组成。 人机接口,**推理机,知识库**,数据库,知识获取机构,解释机构 - 专家系统的核心是( )和( )。 知识库和推理机 - 专家系统的开发步骤是( )、( )、( )、( )、( )。 1. 问题识别 2. 概念化 3. 形式化 4. 实现和测试 - 知识获取的过程 1. 抽取知识 2. 知识的转换 3. 知识的输入 4. 知识的检测 - 知识获取的模式 1. 非自动知识获取(人工移植) 2. 自动知识获取 3. 半自动知识获取 - 机器学习的定义? 机器学习使计算机能模拟人的学习行为,自动地通过学习来获取知识和技能,不断改善性能,实现自我完善。 - 作为人工智能的一个研究领域,机器学习主要研究( )、( )和( )三个方面问题。 1. 学习机理:研究人类学习机制 2. 学习方法:研究人类学习过程 3. 学习系统:根据特定任务的要求,建立相应学习系统 - 一个学习系统一般应该有( )、( )、( )、( )等四个基本部分组成。 **环境,学习,知识库,执行与评价** - 机器学习按系统的学习能力分类可分为( )、( )和( )。 1. 有监督学习(有标签数据) 2. 无监督学习(无标签数据) 3. 弱监督学习(部分标签数据+大部分无标签数据) - 弱监督学习方法主要有( )、( )和( )。 1. 半监督学习(少量标签数据+大量无标签数据) 2. 迁移学习(举一反三) 3. 强化学习(对于外部环境的反馈调整自身) - 按学习时所采用的的推理方式进行分类,机器学习可分为( )和( )。 1. 基于演绎的学习(基于演绎推理) 2. 基于归纳的学习(基于归纳推理) - 按学习方法分类,机器学习可分为( )、( )、( )、( )和( )等。 1. 机械式学习(记忆学习) 2. 指导式学习 3. 类比学习 4. 示例式学习 5. 解释学习 - 按综合属性分类,机器学习可分为( )、( )、( )和( )等。 1. 归纳学习 2. 分析学习 3. 连接学习 4. 遗传算法以及分类器系统 - 深度学习的实质是什么? 深度学习的实质是通过构建具有很多隐层的机器学习模型和海量的训练数据,来学习更有用的特征,从而提升分类和预测的准确性。 - 知识发现和知识挖掘 知识发现(KDD) 知识挖掘(DM) - 知识发现的任务 1. 数据总结 2. 概念描述 3. 分类 4. 聚类 5. 相关性分析 6. 偏差分析 7. 建模 - 知识发现的方法 1. 统计方法 2. 粗糙集 3. 可视化 - 知识发现的对象 1. 数据库 2. 数据仓库 3. web信息 4. 图像和视频数据 - 人工智能设计语言 LISP和PROLOG是早期的人工智能程序设计语言 # 第八章 人工神经网络及其应用 - 人工智能的三大流派思想中连接主义(或称为仿生学派流派)的基础是( )。 人工神经网络(ANN) - 神经元的标准数学模型由( )、( )和( )三部分组成。 1. 加权求和 2. 线性动态系统 3. 非线性函数映射(sigmod函数,Relu函数,阶跃函数) - 神经网络的学习就是调整神经网络的( )或者( ),使输入输出具有需要的特性。 连接权重 结构 - 神经网络的结构有( )和( ) 前馈型(BP神经网络) 反馈型(Hopfield神经网络) - BP算法包括( )和( )两个过程。 信号的正向传播 误差的反向传播 - BP神经网络的学习算法为( ) 误差反传算法(反向传播) - 离散型Hopfield神经网络的稳定性 当连接权重构成的矩阵是非负对角元的对称矩阵,则该网络就具有串行稳定性 当连接权重构成的矩阵是非负定矩阵,则该网络具有并行稳定性 - 显式的知识表示方法有哪些?隐式的知识表示方法有哪些? 显式有:一阶谓词表示法,产生式表示法,语义网络表示法,框架表示法等 隐式有:神经网络知识表示 - 深度神经网络的学习算法称为( )。 深度学习 - 描述一个神经元的输入输出关系的函数称为该神经元的( ) 一个神经元的输入输出关系的函数通常被称为该神经元的**特性函数**(Characteristic Function)或**激活函数**(Activation Function) - 卷积神经网络(CNN)包括哪些层? 卷积层 前向池化层 全连接层 - 卷积神经网络使用的4个关键技术分别是( )、( )、( )和( )。 1. 卷积神经网络的局部连接 2. 卷积神经网络的权重共享 3. 卷积神经网络的多卷积核 4. 卷积神经网络的池化 - 深度学习的模型可大致分为( )和( )。 判别模型 生成模型 - 生成对抗网络(GAN)的核心思想是( )。 GAN 的核心思想源于博弈论的纳什均衡 - 生成对抗网络中判别器的目的是( ),生成器的目的是( )。 判别器:正确区分真实数据和生成数据,最大化判别准确率 生成器:尽可能逼近真实数据的潜在分布 - 生成对抗网络(GAN)是由( )和( )两部分构成。 生成网络 判别网络 - 生成对抗网络的缺点是什么? 其训练过程具有强烈不稳定性,实验结果随机具体有以下几点: 1. 训练过程难以收敛,经常出现震荡 1. 训练收敛,但是出现模式崩溃 1. 训练收敛,但是GAN还会生成一些没有意义或者现实不可能出现的图片 # 第九章 智能体与多智能体系统 - 智能体(Agent)的特性 1. 自主性 2. 反应性 3. 社会性 4. 进化性 - 智能体(Agent)的结构 **Agent=体系结构+程序** - 多智能体(MAS)的体系结构 1. 网络结构:网络结构中的Agent都是直接通信的,通信和状态知识都是固定的 2. 联盟结构:若干较近的Agent通过一个协作者Agent进行交互的,远程的Agent交互是通过局部Agent群体的协作者的Agent协作完成的。 3. 黑板结构:黑板结构类似于联盟结构,但是黑板结构中的局部Agent把信息存放在可存取的黑板中,实现局部的数据共享。 - 智能体的通信类型 1. 使用Tell和Ask通信 2. 使用形式语言通信 - Agent通信方式 1. 黑板方式 黑板系统主要支持分布式问题求解。 主要有三个组成部分:知识源,黑板,监控机制 2. 消息/对话系统 消息/对话系统是实现灵活和复杂问题的协调策略的基础。 有两种方式来实现Agent之间的消息传递:**直接传递和通过中介传递** - 智能体的通信语言 1. 知识交换格式语言KIF,主要基于谓词逻辑,可以作为描述专家系统,数据库,多智能体的知识表示工具。 2. 知识查询操纵语言KQML,定义了一套消息表示机制和消息传递机制,构建了一种标准通用框架。 - 多智能体系统的协调 协调是指一组Agent完成一些集体活动时相互作用的性质 主要有以下四种协调方法: 1. 基于集中规划的协调 2. 基于协商的协调 3. 基于对策论的协调 4. 基于社会规划的协调 - 多智能体的协作 协作是非对抗的Agent之间保持行为协调的一个特例 协作方法有: 1. 合同网协作 2. 黑板模型协作 3. 市场机制协作 - 多智能体的协商 协商是MAS实现协调,协作,冲突消解和矛盾处理的关键环节。 协商的关键技术主要有: 1. 协商协议 2. 协商策略:协商策略可以分成5类:单方让步策略,竞争型策略,协作型策略,破坏协商策略,拖延协商策略 3. 协商处理 # 第十章 自然语言处理及其应用 - 自然语言处理的五个层次 1. 语音分析:根据音位规则,从语言流中区分出独立的音素 2. 词法分析:从句子中切分出单词,找出词汇中的词素 3. 句法分析:对于句子或短语进行分析 4. 语义分析:将分析得到的句法成分与应用领域的目标表示相关联 5. 语用分析:研究语言存在的外界环境对应语言使用的影响 # 第十一章 人工智能在游戏设计中的应用 - 游戏人工智能分成哪两类? 1. 定性:定性技术是游戏人工智能的基础,用定性技术设计的角色是特定的,可预测的。 2. 非定性:非定性技术是定性技术的一种提高,用非定性技术设计出的角色具有某种程度的不确定性和不可预测性。